MapReduce
前言
MapReduce 是一個 Google 提出的軟體架構,適用於大規模資料的並列運算
Prerequistites
- File System
- 資料的儲存系統
- 有許多不同型態,例如以垂直結構為主的目錄與資料夾、Object storage 等
- Distributed File System
- 分散式檔案系統,透過一大群機器(cluster)互相合作,對外表現如同一個巨大的 file system,將 data 切成特定大小的 chunks (如 4 MB 或 64 MB),會透過 central control plane 會決定應該將 chunks 存在哪一個 node,後續應該去哪一個 node 讀取 chunks
- 主要操作方式是透過網路以定義好的通訊協定進行資料存取
- 目前現有的產品有 Google File System (GFS)、Hadoop Distributed File System (HDFS)
- Hadoop
- 支持 MapReduce 與資料管線的 open-source 框架,最重要的中央組件為 Hadoop Distributed File System (HDFS)
各階段簡介
Map 階段
- 負責 filtering 和 sorting 並且組合出一個 key value pair 結果
Reduce 階段
- 負責資料整合
- 以 wordcount 為例,從 Map 傳過來的 key 若一樣,表示同一個字,因此把一樣的 key 做加總,可以得出最後的出總筆數
冪等性(idempotency)特性
- 意義: 當操作多次,結果應呈現一致
- 透過 pub/sub messaging system 應當有冪等性,因為 pub/sub 系統本身允許相同訊息被 consumer 接收多次
- 舉例,增加資料庫某欄位的 integer value,就不是一個具有冪等性的操作,因為保持每次增加的操作後都不會保持跟前一個相同的數值
- 另一舉例,將欄位值設定為 “DONE”,多次重複此操作,還是會顯示為 “DONE”,因此設定為 “DONE” 是一個冪等性操作
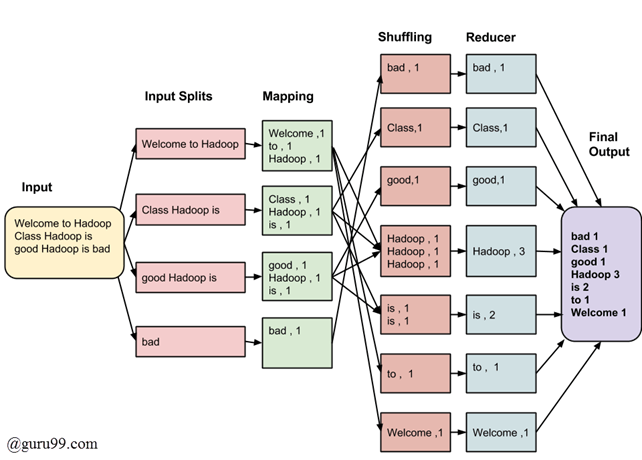
範例
- input
- 要做計算的原始資料,可以是一堆文字清單等
- split
- 把 input 資料做分散處理
- 以 hadoop 來說,當 MapReduce 工作被輸入的時候,會被切割到各個 cluster 裡面等待做處理
- 🔔map
- MapReduce 的 map 階段
- 每一個節點有自己的一份資料要分析,會把對應切割出來的資料建立 key value 的結果
- key 是字本身,value 是 1 代表找到一筆
- combine
- 在 map 的機器進行以下動作
- 將一樣的 key 先做一次加總,避免傳送多次出去,例如 combine 後的結果可能是 “A” 有 2 筆、“B” 有 1 筆等
- shuffle & sort
- 在進入 reduce 階段之前,會先被做一個排序,因此相關的 key 會放在一起
- 比如第一批資料的 “A” 有 2 筆、第二批資料的 “A” 有 5 筆…第一批資料的 “B” 有 1 筆、第二批資料的 “B” 有 3 筆
- 🔔reduce
- 此階段會做實際的加總,因此每一個 key 的 value 會被加總
- output
- 最後得到的結果
參考資料 👐
- system expert
- wiki MapReduce
- introduction-to-mapreduce
🍀 最後,若喜歡我的分享,可以幫我拍拍手👏,是對我最大的鼓勵!✨