Kafka
- 最先是由 LinkedIn 創立的一款分散式訊息系統 (distributed messaging system),由 Scala 和 Java 編寫的 open-source 專案
前言
Prerequistites
📌 功能
-
高效能、容錯且具可擴展性的平台
-
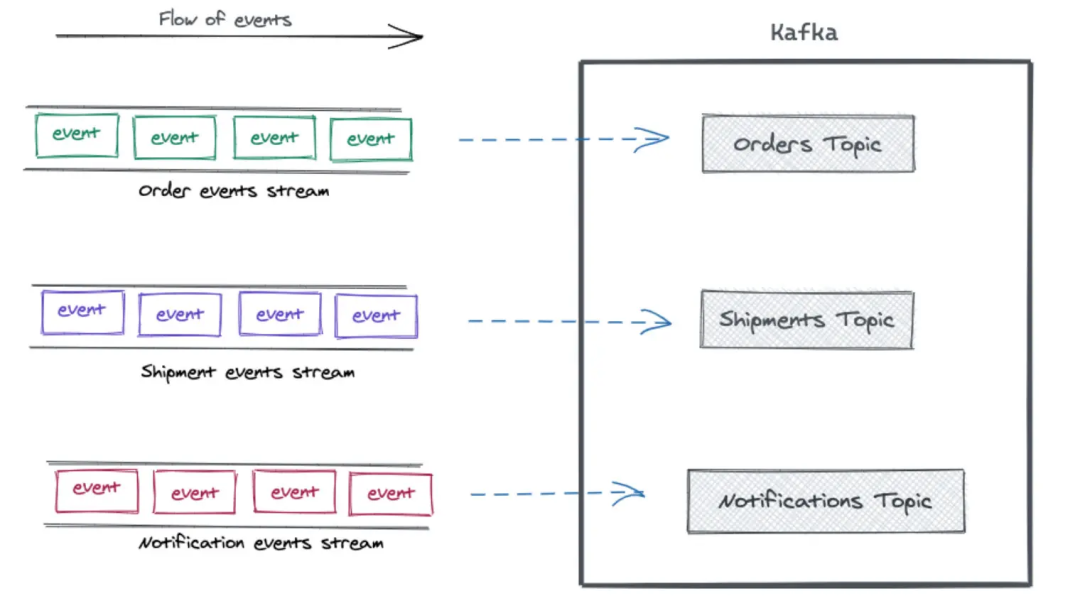
用於建置即時串流資料管道,並以 pub/sub pattern 來管理生產者與消費者的資料
- Kafka Connect 是 Apache Kafka 的開放原始碼元件,是一個用於將 Apache Kafka 與外部系統 (如資料庫、機碼值存放區、搜尋索引和檔案系統) 連接的架構。
- 串流資料是一種小型記錄或事件 (記錄或事件通常為幾 KB 大小的記錄) 的持續串流,這類的記錄則由數千台機器、裝置、網站和應用程式所產生。串流資料包含各式各樣的資料,例如客戶使用您的行動或 Web 應用程式產生的日誌檔、電子商務採購、遊戲中的玩家活動、來自社交網路
-
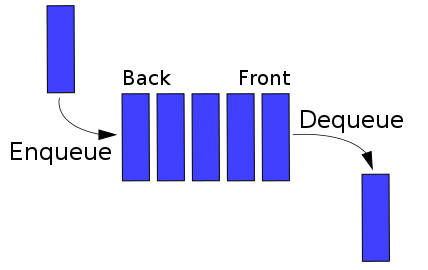
資料取用的順序以 FIFO (First In First Out) 作為原則
💫最重要的觀念💫
如何達到高效能、容錯且可擴展的呢?
partition
-
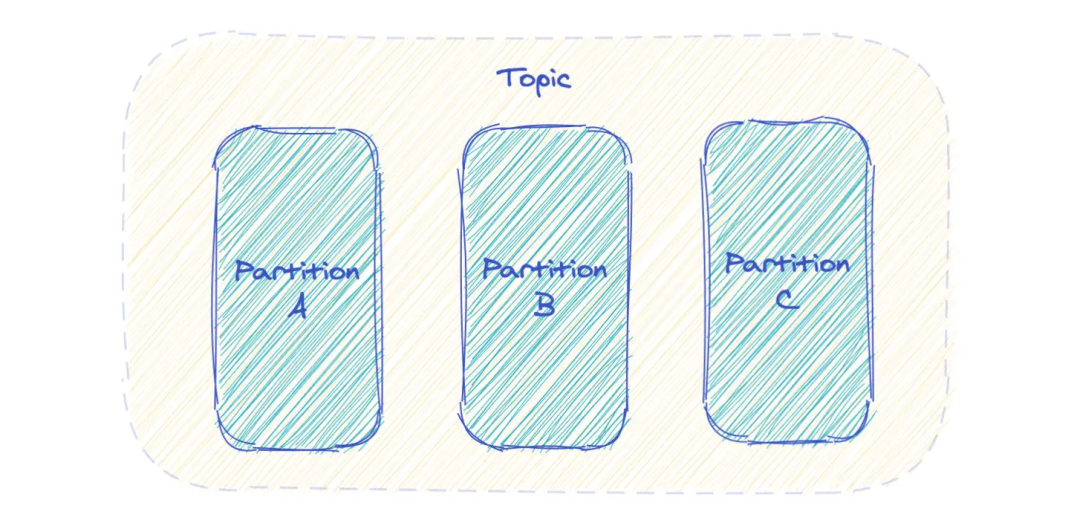
Partition 是最小的存儲單元
-
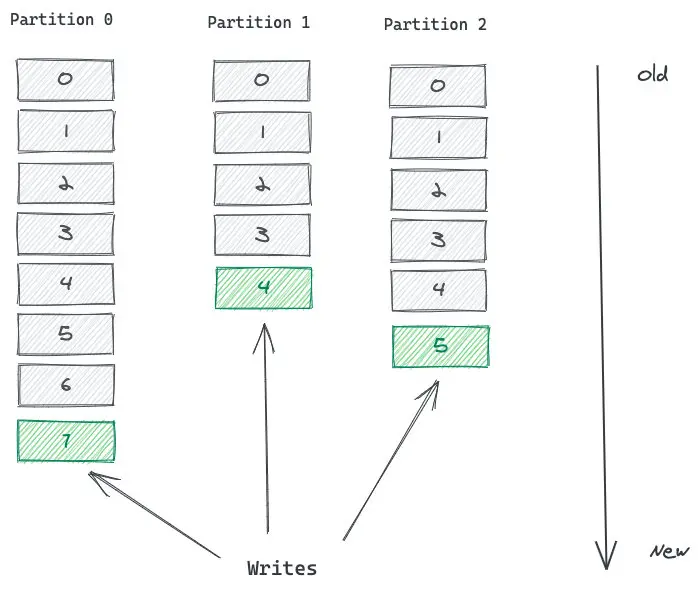
一個 Partition 內部消息有序,一個 Topic 跨 Partition 是無序的。
-
一個 Kafka cluster由多個 Broker(就是 Server) 構成,每個 Broker 中含有 cluster 的部分數據。
- Partition 分佈在多個 Broker 的話,Consumer 的多個實例就可以連接不同的 Broker
- 好處
- Topic 就可以水平擴展
- 支持更多的 Consumer
- 一個 Consumer 實例負責一個 Partition
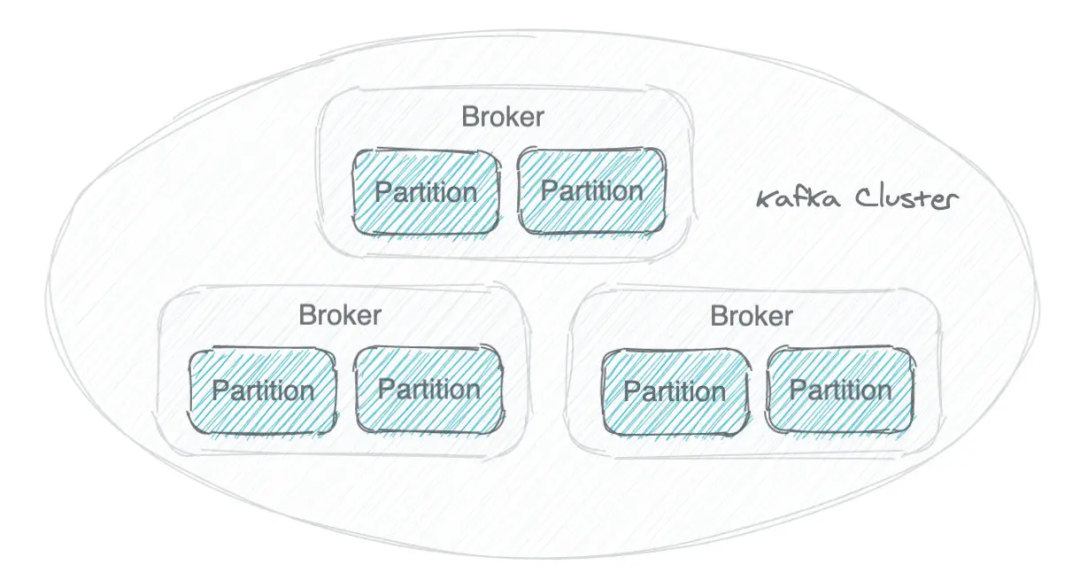
-
數據冗餘
- 一個 Partition 生成多個副本,並且把它們分散在不同的 Broker。
- 如果一個 Broker 故障了,Consumer 可以在其他 Broker 上找到 Partition 的副本,繼續獲取消息。
-
寫入 Partition 的方式
- 給 Kafka 決定
- 若沒有 key 則 kafka 以 round robin 方式將訊息寫入 partition,但這樣就不保證順序性了,若需要有順序性,請參考下面一個方式
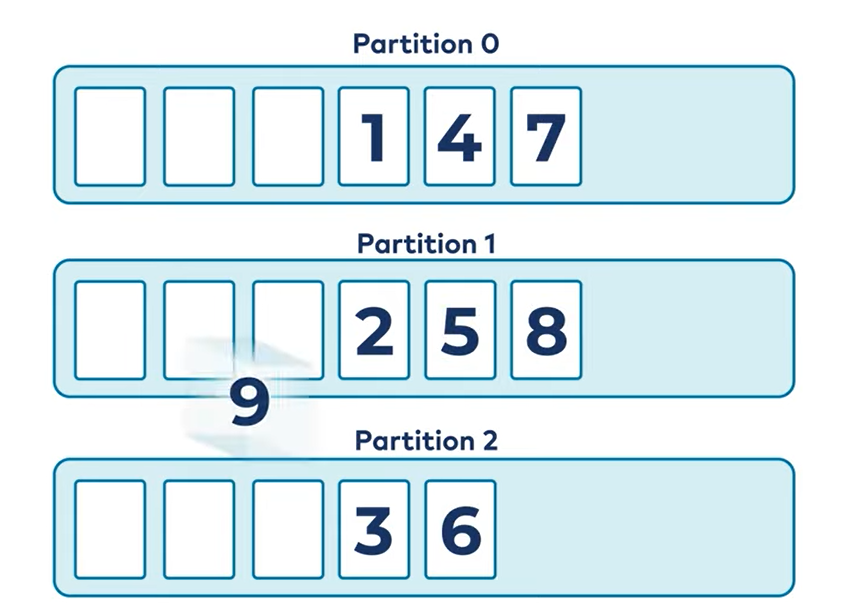
- 若沒有 key 則 kafka 以 round robin 方式將訊息寫入 partition,但這樣就不保證順序性了,若需要有順序性,請參考下面一個方式
- 使用 Partition Key 寫入特定 Partition
- kafka 保證使用相同的 key 會將訊息放到同一個 partition,並且保證順序性 ( in order )
- 舉例,如果相同客戶的資訊有序地取得,表示需要放在同一個 partition,可以使用 customer id 作為 partition key,這樣同一個 customer 的資料都會放到同一個 partition
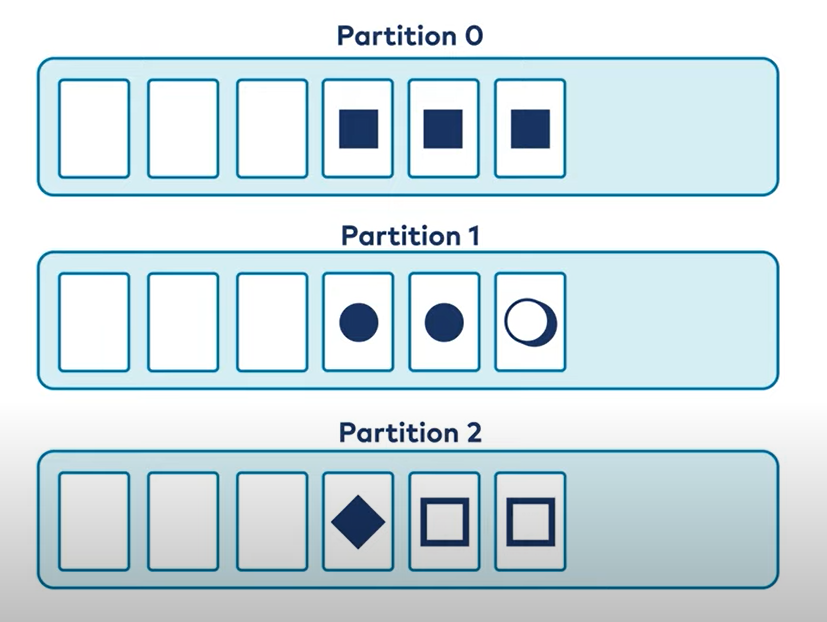
- 給 Kafka 決定
-
讀取 partition
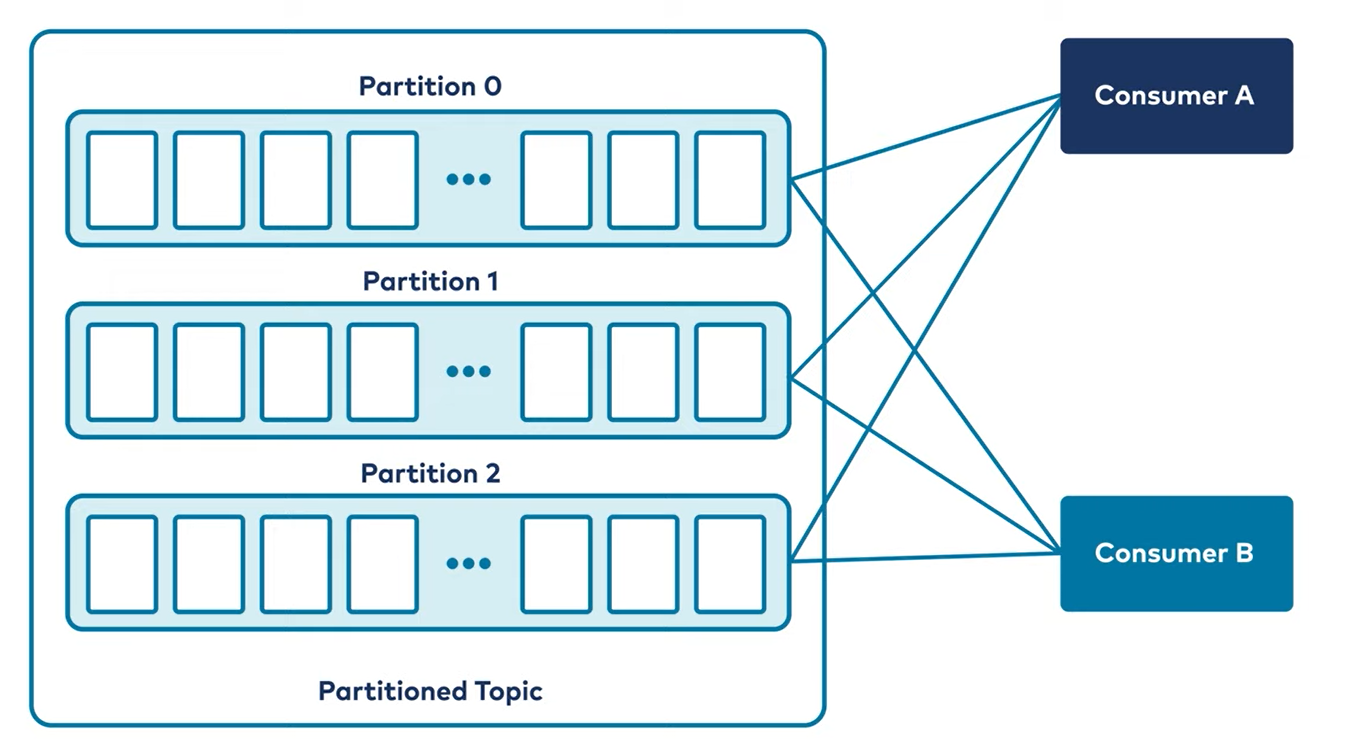
- consumer group
- 多個 consumer 組合成一個 consumer group,目的是為了水平擴展(scale out) consumer
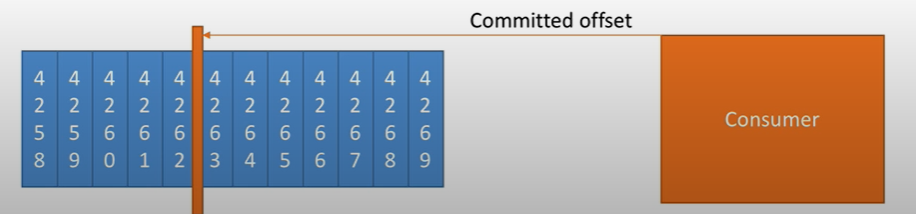
- 決定 consumer group 要從哪裡開始讀取資料的關鍵是 consumer offsets
- offsets 會被存在 topic name 中
- 如果 consumer 讀取資料完畢,則會 commit offsets
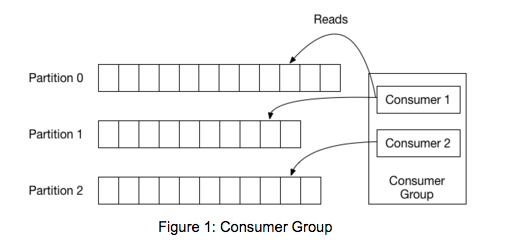
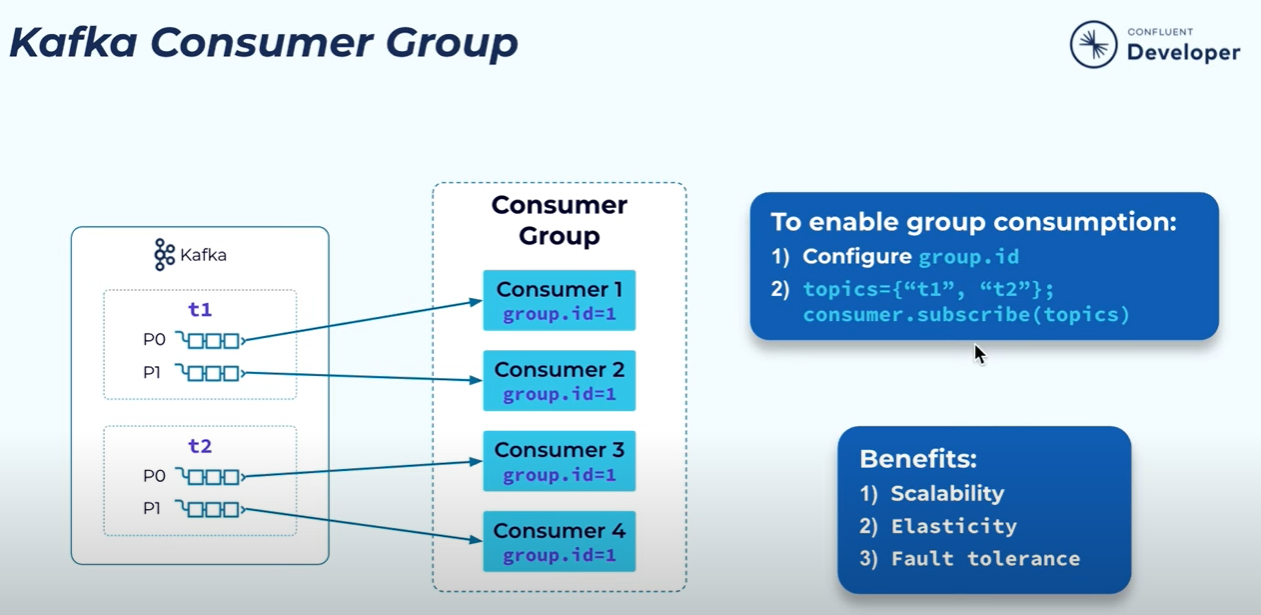
- consumer group
apache zookeeper
- an open-source server which enables highly reliable distributed coordination
- 通過冗餘服務實現高可用性
參考資料 👐
- Apache Kafka® 101: Partitioning
- 細說 Kafka Partition 分區
- Apache Kafka vs Confluent: Comparing Features & Capabilities
- 全受管 Apache Kafka - Amazon MSK 常見問答集 - Amazon Web Services
🍀 最後,若喜歡我的分享,可以幫我拍拍手👏,是對我最大的鼓勵!✨